
※本記事は、北海道テレビ放送株式会社コンテンツビジネス局 ネットデジタル事業部所属の木原光太郎様へのインタビューを元に制作した記事となります。
――担当者の記憶と手作業に依存した映像検索・視聴率分析。番組データの活用までに多くの時間を費やしていたことが課題に
北海道テレビ放送株式会社(以下、HTB)様では、オンエア済みの番組映像を活用した企画検証や視聴率分析において、映像素材の検索やデータ照合に多くの時間を要していました。テレビ局にとってオンエア済みの番組映像は今後の企画のための振り返りを行なうための重要な資産です。その中で、どのシーンでどのくらいの視聴率が取れているかを知ることは非常に重要であるにも関わらず、必要なシーンを探すには手作業で同時録画された映像内を探すしかありませんでした。また、映像と視聴率データは別々で管理されているため、それらを関連付けた分析にも多大な負担がかかっていました。
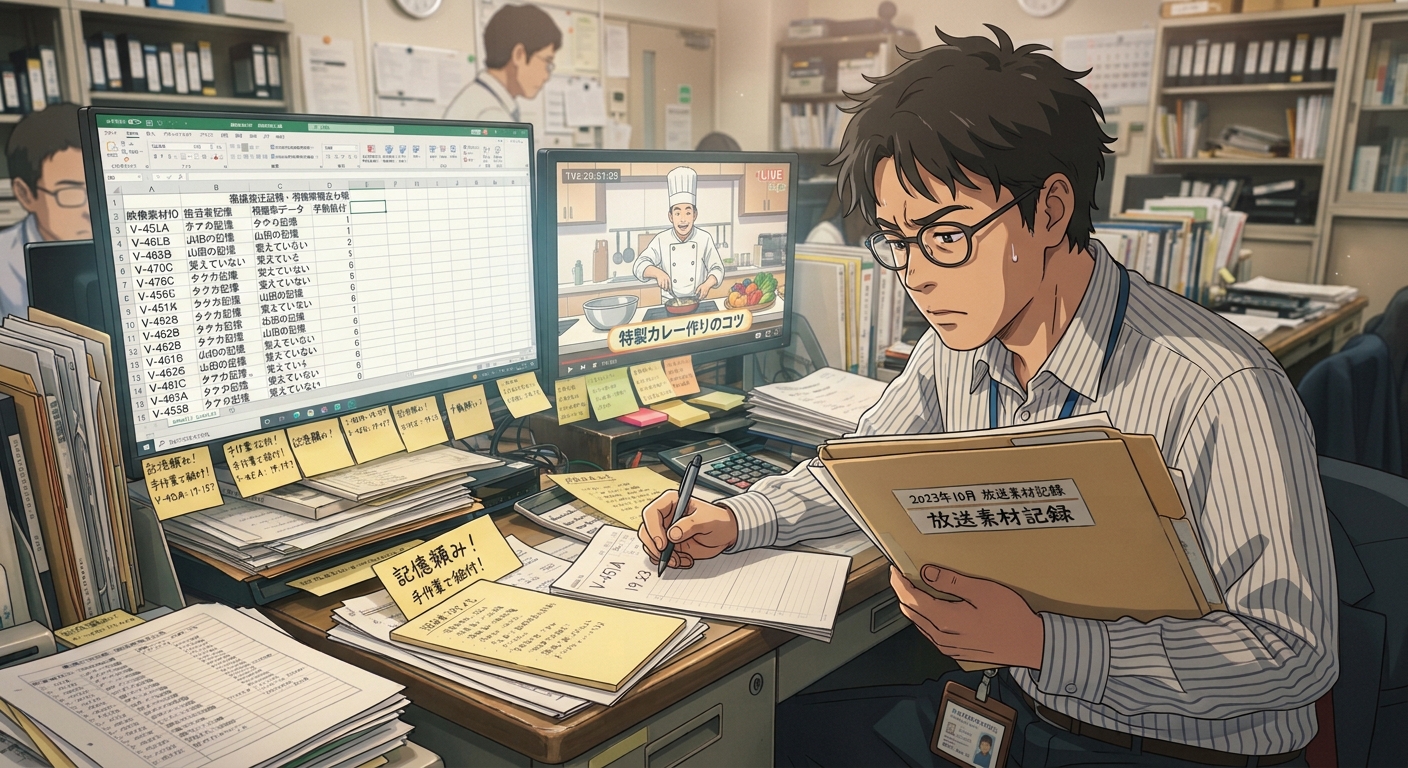
特に過去の映像を参照する際は、アーカイブ室に保存されているテープから必要な映像を確認する作業が必要でしたが、担当者の記憶を頼りに該当素材を探すことになるため、特定のシーンを探し出すのに多くの手間がかかっていました。こうした課題を解決するため、Serverless Operationsの支援の元、HTB様はAWSと生成AIを活用し、番組映像の自動解析から視聴率データとの統合、映像検索までを実現する新たなデータ分析基盤を内製開発しました。
――生成AI(マルチモーダルLLM)を活用した新たな番組分析システムを開発。人力で行っていた分析作業の大幅な効率化を実現
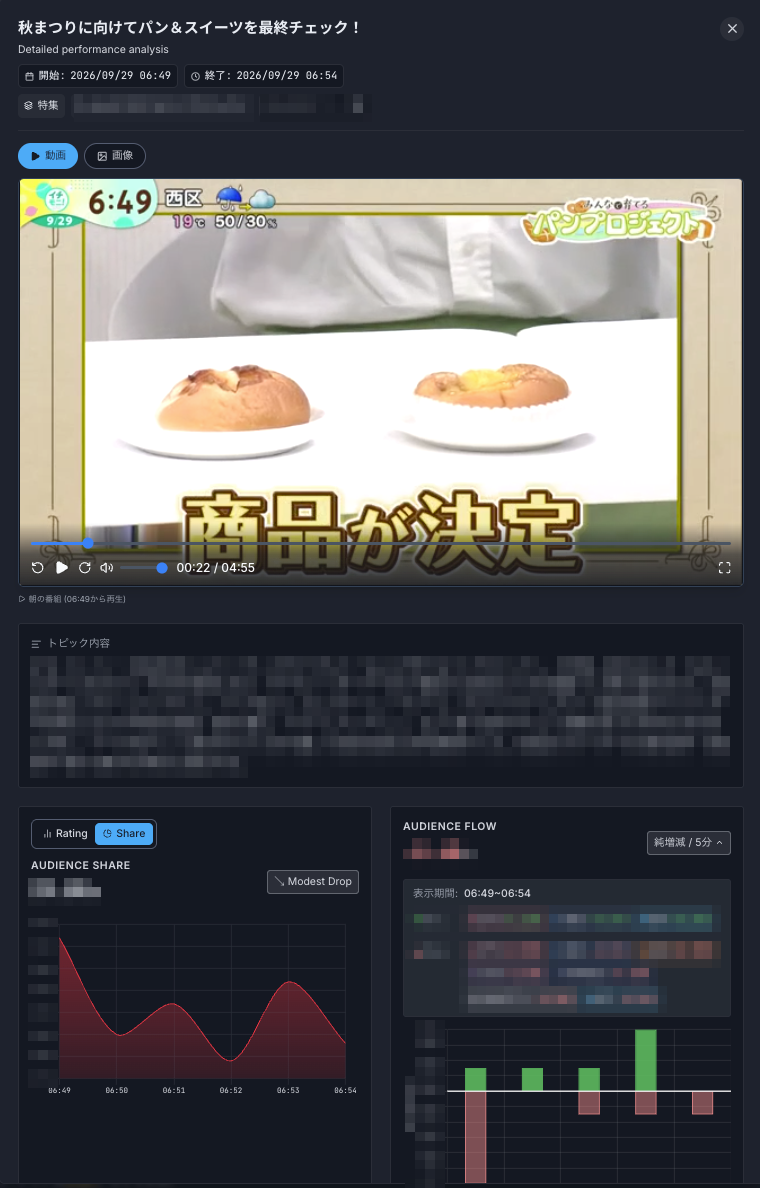
これらの課題を解決するために自局のオンエア映像をマルチモーダルLLM(画像、音声、動画といったテキスト以外の情報を直接入力・統合して理解し、推論・出力ができるAIモデル)で自動解析し、視聴率データと統合してAmazon OpenSearch Serviceに蓄積、検索できる番組分析システムをAWS上に構築しました。各区間に分単位の視聴率推移を紐付けシーンごとの素材を検索することが可能です。画面では映像再生と視聴率推移を同時に確認でき朝・夕方の情報番組で日次稼働しています。
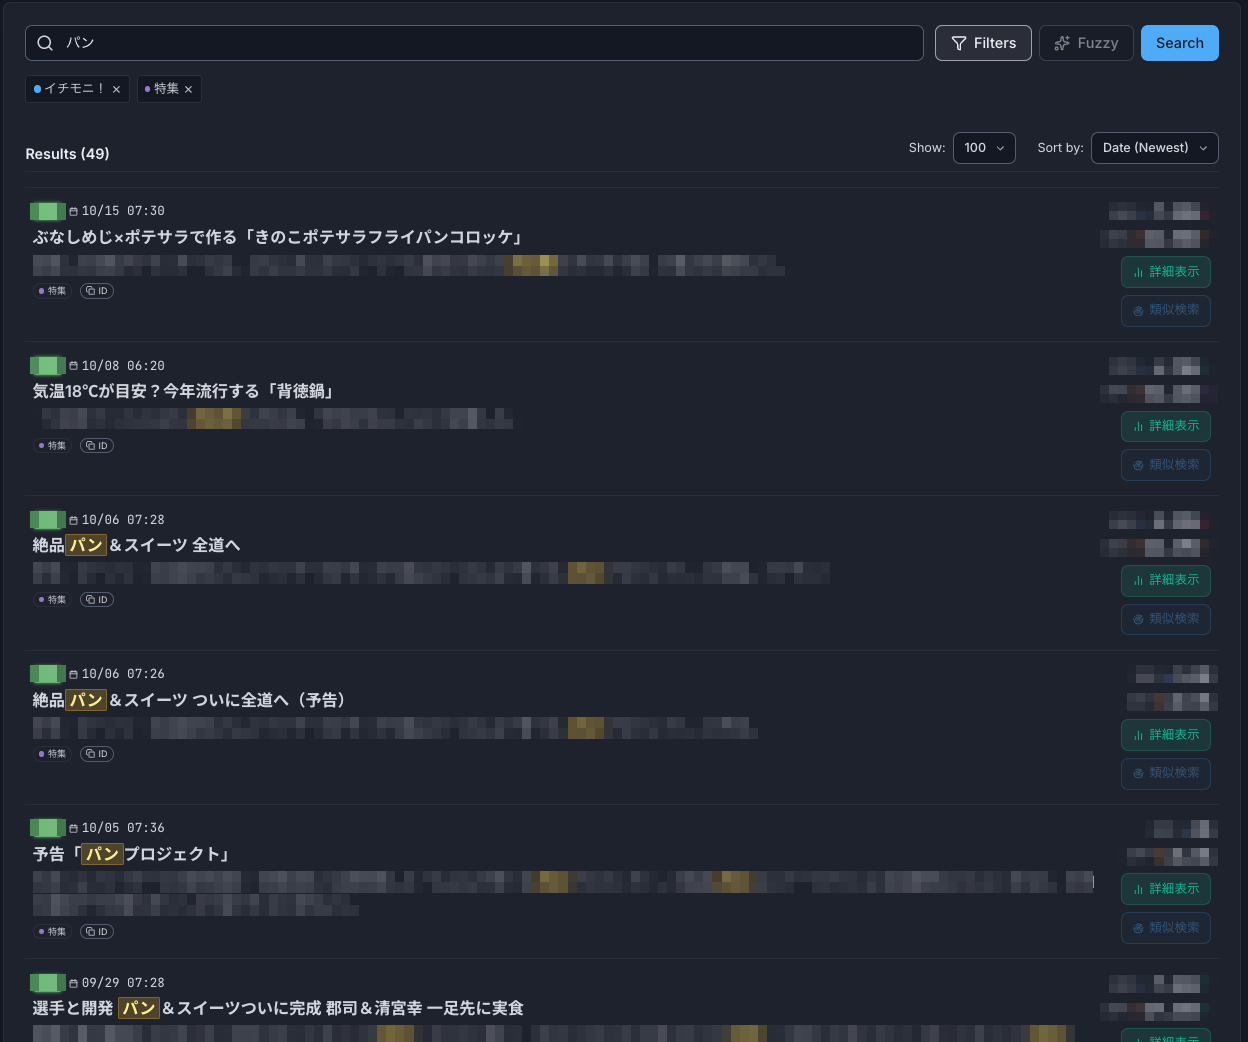
従来、過去の映像を探すにはアーカイブ室のテープを担当者の記憶を頼りに確認する必要がありましたが現在はキーワードを入力するだけで自局の過去素材を横断検索し、その場で映像をプレビューできます。番組名や放送日を覚えていなくても断片的な言葉や意味の近い表現から目的のシーンにたどり着けるため、担当者以外でも素材を探せるようになりました。また、映像を再生しながら分単位の視聴率推移を同じ画面で確認できるため「どの話題やシーンで数字が動いたか」を直感的に把握できるようになりました。
――マルチモーダルLLMとAWSを活用し、番組映像を検索可能なデータへ変換する仕組みを構築
以下の構成図は本システムのアーキテクチャを示したものです。本システムの特徴は赤枠で示した「Pre-processing(前処理)」の部分にあります。
Amazon S3にアップロードされた動画ファイルに対し、AWS Step Functionsを用いて処理を制御し、生成AIサービスであるAmazon BedrockおよびGoogle CloudのGeminiを活用して、検索可能なデータ形式へと変換します。変換したデータは検索エンジンサービスであるAmazon OpenSearch Serviceに登録されます。これにより、自然言語を用いた番組横断的なシーン検索に加え、各シーンと視聴率データを紐付けた分析が可能になりました。
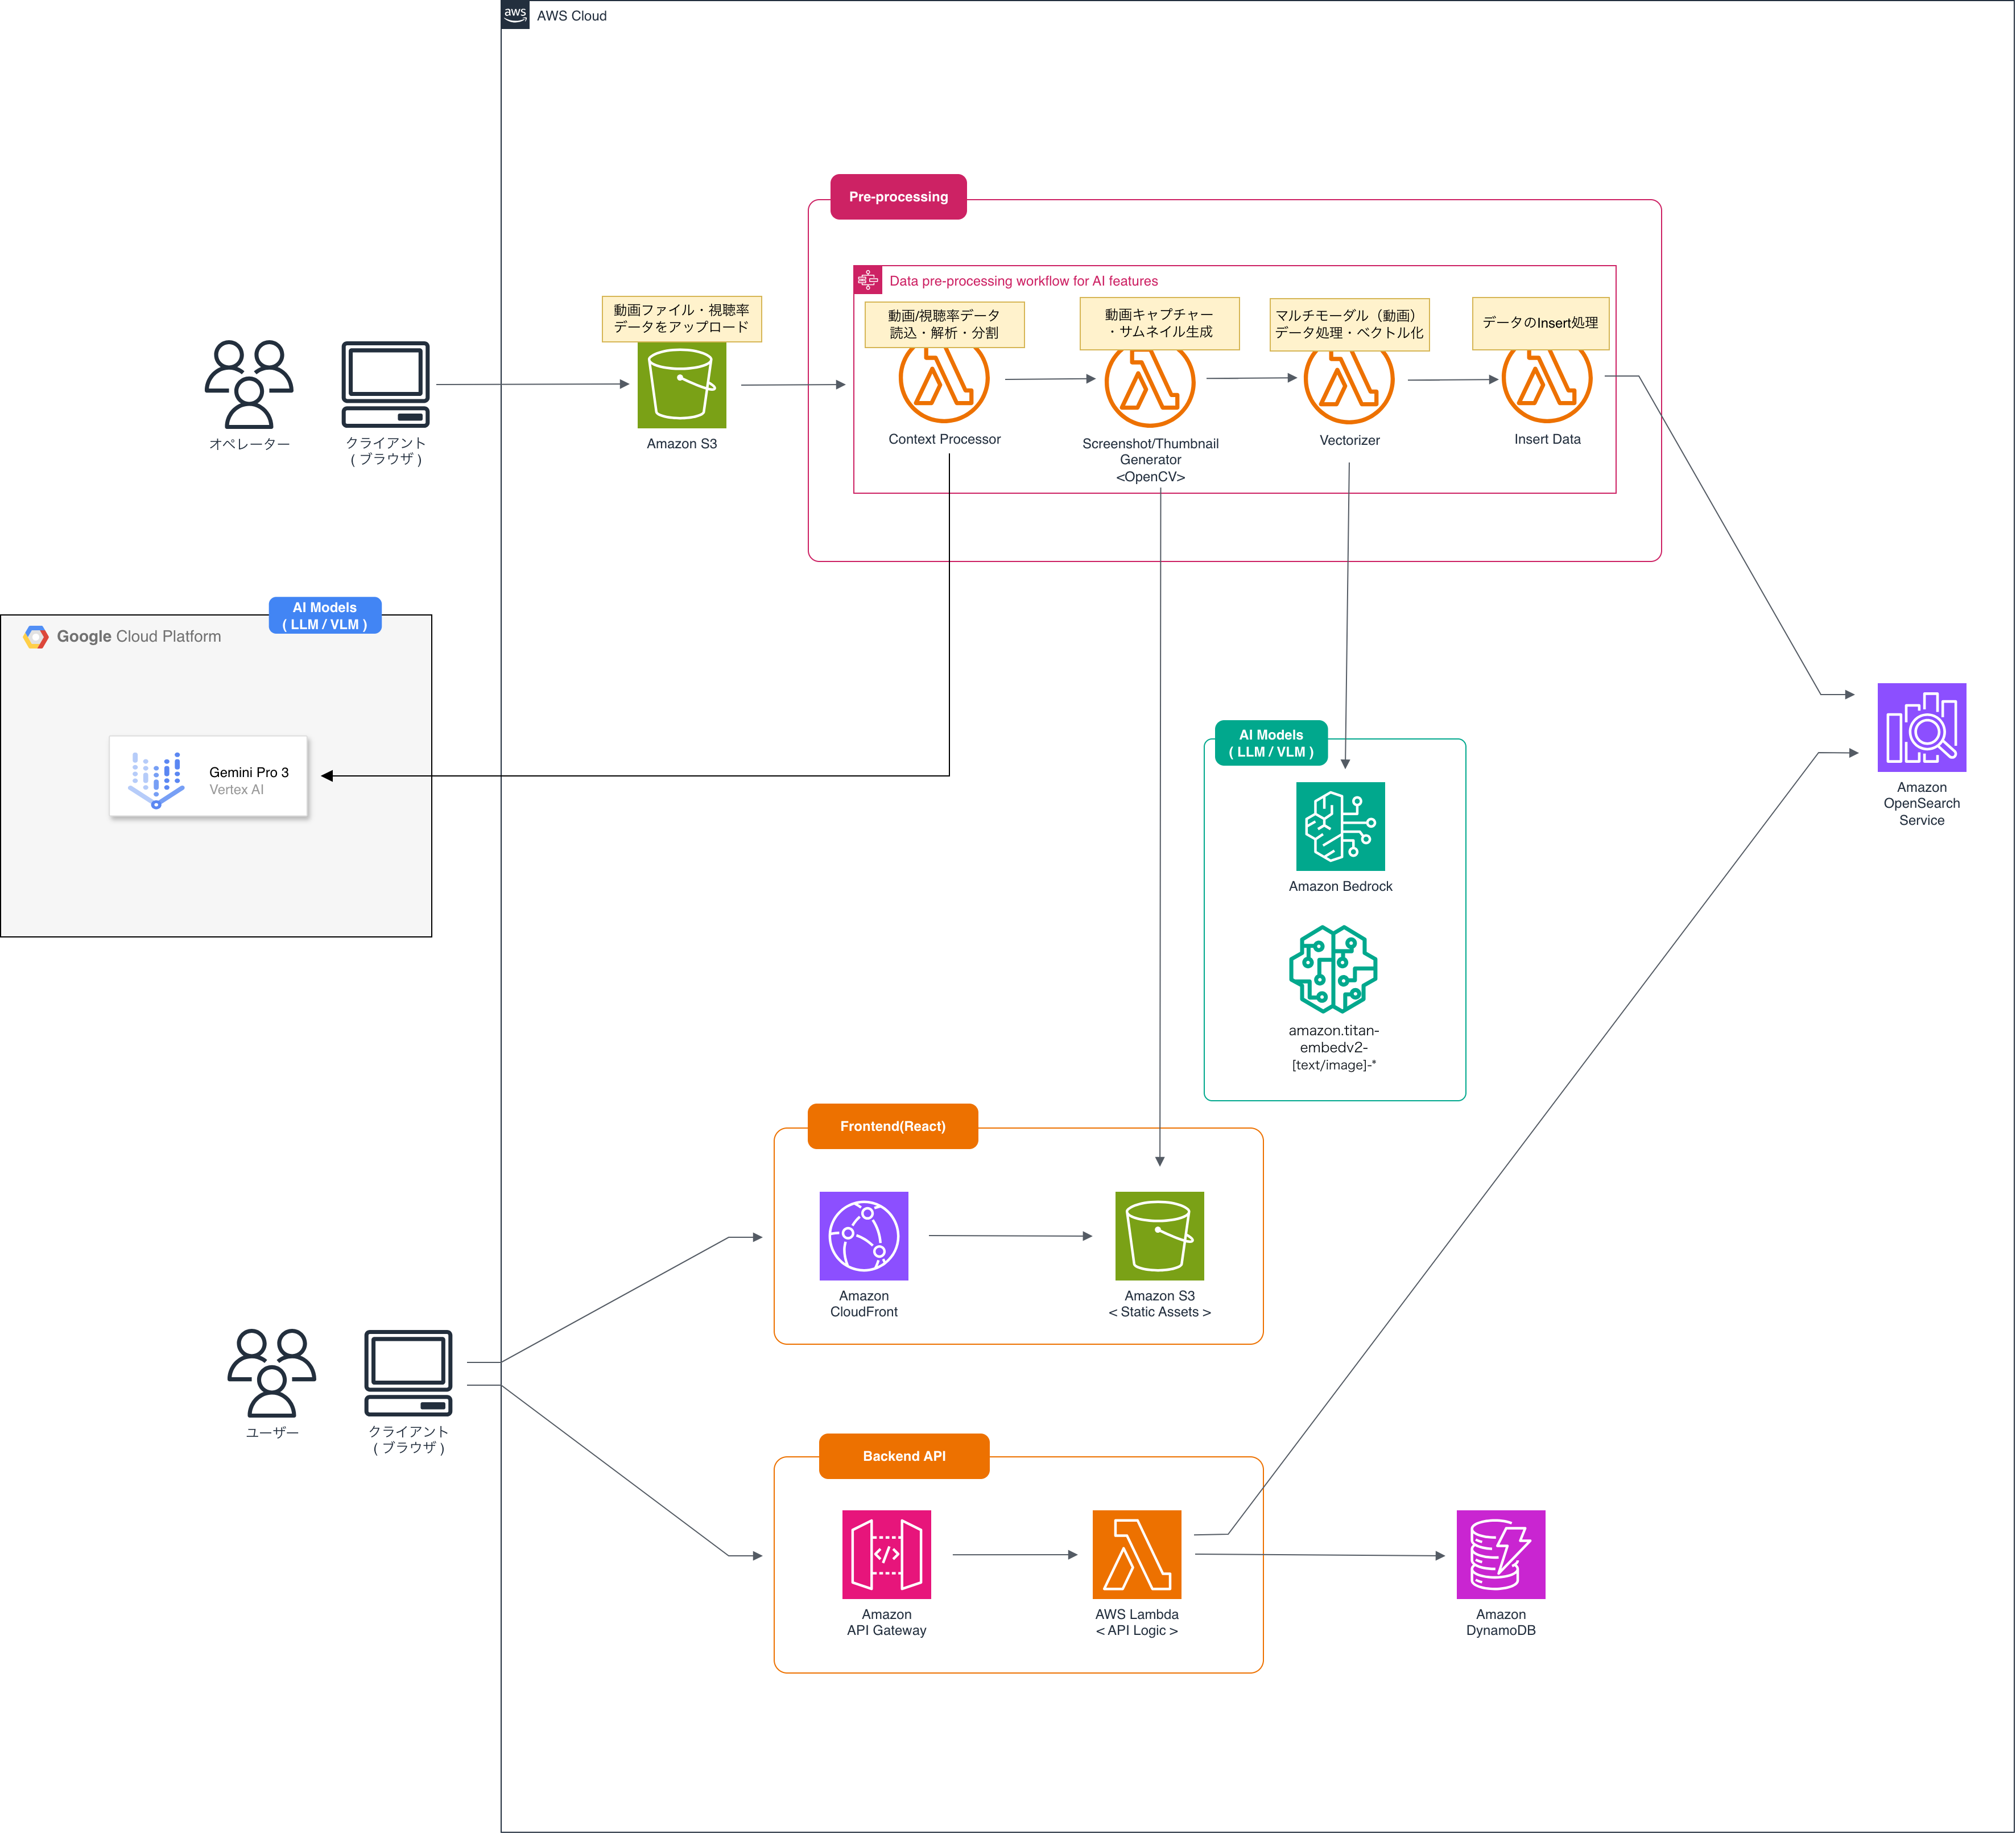
Pre-processing(前処理)を具体的に掘り下げると以下のようなワークフローが組まれています。
- Context Processor
アップロードされた番組動画と視聴率データをロード、番組動画は分刻みに分割します。Gemini Pro3を使いシーン毎の区間の境界・種別・コーナー名・タイトル・要約を抽出、さらに時間をキーとして分刻みに分割されたシーンに視聴率データをマッピング。厳密に定義したスキーマのJSONで出力します。 - Screenshot/Thumbnail Generator
各シーンの検索結果に表示するサムネイルをOpenCVを使って切り出します。Geminiで取り出した映像情報の中間地点をキャプチャとして取得し、Amazon S3にアップロードします。 - Vectorizer
1のContext Processorで抽出した音声情報とサムネイルをAmazon BedrockのAmazon Titan Embbeting Text V2モデルを利用してベクトル化、自然言語で各シーンを音声情報から検索できるようにします。 - Insert Data
加工したデータをAmazon OpenSearch Serviceに投入します
――生成AIの解析精度を高める「検査・修正」の仕組み。LangGraphを活用し、精度とコスト効率を両立
Context Processorでは生成AIによる映像解析の精度を高めるための処理を行っています。
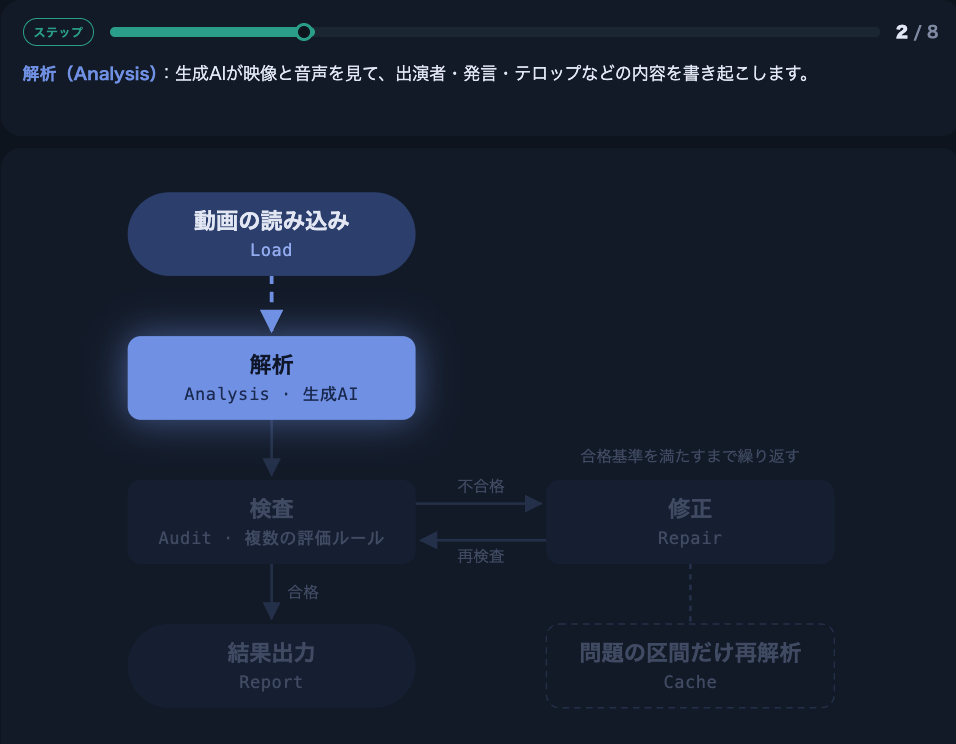
生成AIによる映像解析では、番組内のコーナーの開始・終了時刻がずれたり、必要な情報が抜け落ちたり、実際の映像とは異なる内容が生成されたりすることがありました。そこでAIが生成したデータを検証し、問題があれば修正する仕組みを構築しました。
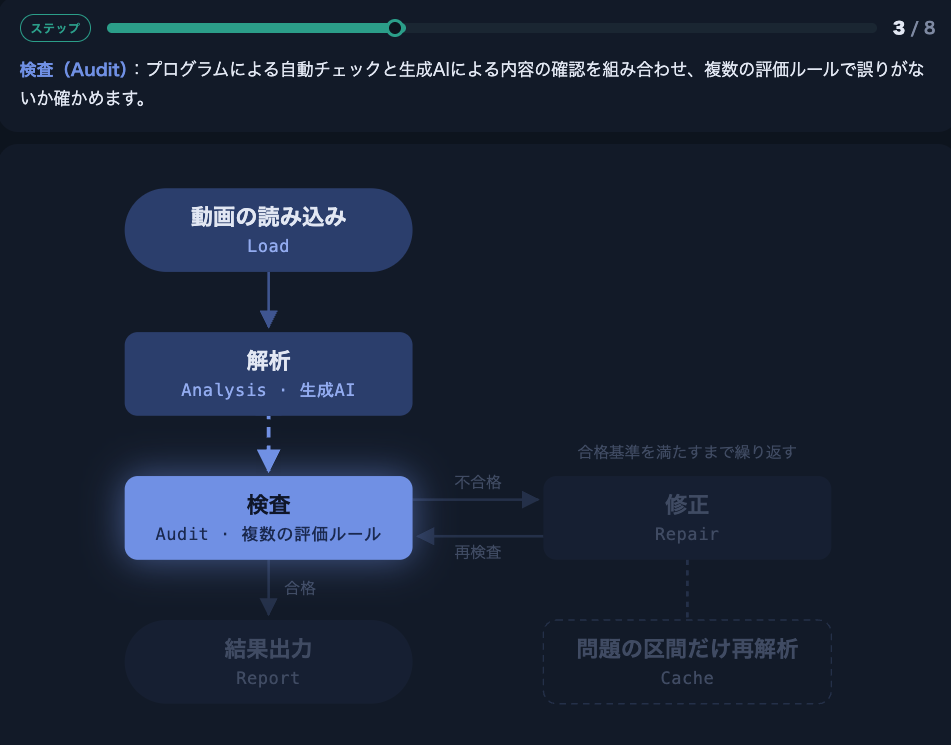
具体的には各シーンの開始・終了時刻に矛盾がないか、必要な情報が揃っているかといった明確なルールで判断できる項目はプログラムによって自動的に検証します。一方、映像の要約が適切かどうかなど、単純なルールでは判断が難しい項目については生成AIを活用して検証しています。
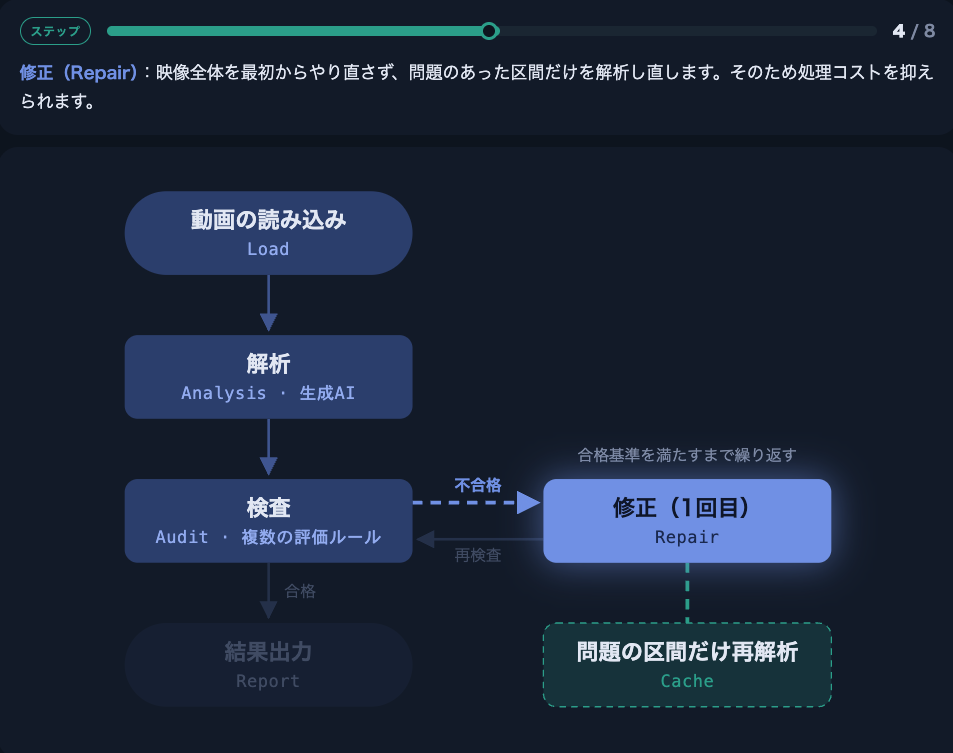
この一連の処理には、LLMを活用したワークフローを構築できるフレームワーク「LangGraph」を採用しています。Context Processor内では、動画の読み込み(Load)→ 解析(Analysis)→ 検査(Audit)→ 修正(Repair)→ 再検査(Audit)→ 結果出力(Report)というワークフローを構築し、検査フェーズでは複数の評価ルールを設け、あらかじめ定めた合格基準を満たすまで「修正(Repair)→ 検査(Audit)」の処理を繰り返します。
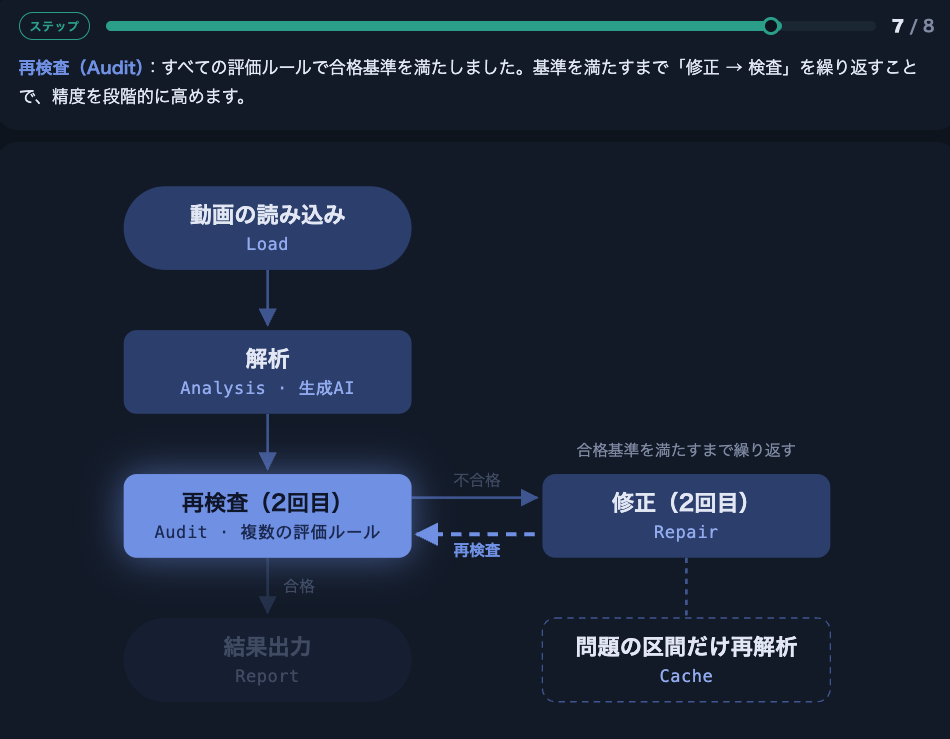
これにより生成AIの出力結果を段階的に改善し、精度の高いデータを生成できるようにしています。また、修正が必要な場合も映像全体を最初から解析し直すのではなく問題のある区間だけをキャッシュし再解析することで処理コストの抑制も図っています。
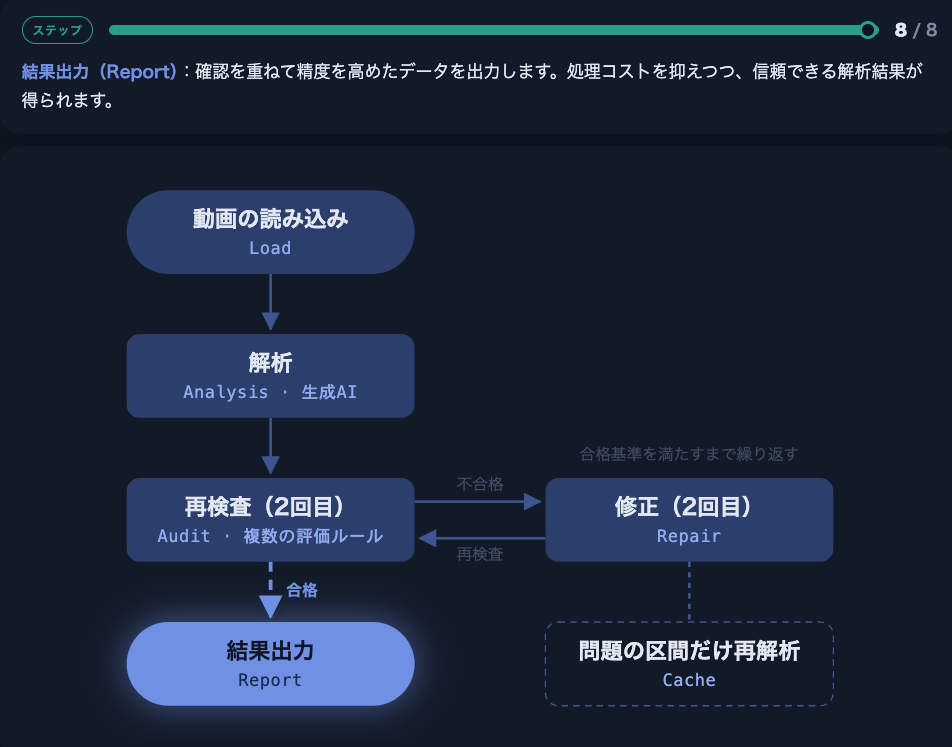
プログラムによる自動検証と生成AIによる内容の評価を組み合わせ検査と修正を繰り返すことで、処理コストを抑えながら映像解析の精度と信頼性を高めています。
――Serverless Operationsが生成AIシステムの内製開発を技術面から支援。専門的な知見で開発時の課題解決を後押し
今回のプロジェクトでは、HTB様が主体となってシステムの内製開発を進め、Serverless Operationsが技術面から支援しました。特に評価いただいたのが技術選定とシステム設計に関するアドバイスです。将来的な機能拡張も見据えたデータベースやシステム構成の選定に加え、LLMによる映像解析の精度向上についてもLangGraphを活用した具体的な改善アプローチを提案しました。
生成AIを活用したシステム開発では、その特性上必ずしも期待どおりの結果が1回で得られるとは限りません。そのためプロンプトの改善やデータ構造の最適化、ワークフローの設計、生成AIへの制約条件の設定など、様々なアプローチを組み合わせながら試行錯誤を重ねる必要があります。HTB様からは、こうした場面で専門的な視点からアドバイスを得られたことで、試行錯誤の方向性が明確になり開発をスムーズに進められたとの評価を頂いています。
AIエージェントをアプリケーションに組み込み、ユーザーにとってより価値の高いプロダクトを提供するためには生成AIの特性や出力品質を十分に理解しそれらを踏まえた適切なシステムアーキテクチャを設計することが重要です。Serverless Operationsでは、AWSを中心としたさまざまなAIアプリケーションの開発実績と、そこで培った技術的なノウハウを有しています。今回のHTB様の事例のような内製開発支援はもちろん、要件定義から設計・実装までを担う受託開発にも対応しています。
AIアプリケーションの開発や既存業務への生成AIの導入をご検討の企業様は、ぜひお気軽にお問い合わせください。 お客様の課題や開発体制に応じて最適なアプローチをご提案しAIを活用した業務改革や新たな価値の創出を支援してまいります。